PhysBrain 1.5登顶开源物理AI榜
深度机智发布PhysBrain 1.5,8B版本在28项物理AI基准中以72.5分位列开源第一,逼近GPT-6 Astra与Gemini 3.6 Flash。更值得关注的是,它试图把空间理解、动作生成和状态预测收进同一个闭环。
PhysBrain 1.5 登顶开源榜,物理 AI 开始拼闭环
9月9日,深度机智发布物理基座模型 PhysBrain 1.5。按照其公开的28项具身空间智能与规划基准,8B版本拿到72.5分,位列参评开源模型第一;2B版本得分66.6,虽然按官方规则不参与排名,但单看分数,也超过了多款更大规模的开源参评模型。
这不是又一个把视觉问答分数刷高的多模态模型。PhysBrain 1.5真正值得看的地方,是它把竞争从“模型能不能看懂图片”,往前推到了“模型能不能理解空间、预测动作后果,并据此连续做出下一步决策”。
8B模型,为什么能拿下开源第一
这次评测覆盖五类能力:视觉空间感知、空间与多视角理解、具身认知与规划、空间指向与可供性,以及视觉轨迹推理。换句话说,它测的不只是“这是什么”,还包括“它在哪里”“从另一个角度看是否还是同一个关系”“我应该怎么拿”“拿了之后会发生什么”。
在这套28项基准中,PhysBrain 1.5-8B综合得分72.5,公开信息显示其中14项取得开源最佳、10项位列开源第二。作为对比,Hy-Embodied-VLM-1.0为66.0,RynnBrain 1.1为63.1。
分数差距更有意思。72.5分距离 GPT-6 Astra 的73.3分、Gemini 3.6 Flash 的73.0分都不到1分。需要强调的是,这并不等于一个8B开源模型已经全面超过闭源巨头:不同模型的训练数据、评测设置、工具调用能力和推理预算未必完全一致,单一榜单也不能替代真实机器人测试。
但它至少说明,空间智能这个此前更依赖大规模闭源系统的方向,开源模型已经把整体水位推到了相当近的位置。对开发者而言,能下载、能改造、能在自己的数据上继续训练,往往比榜单上多零点几分更重要。
几个分项结果也能说明模型能力的落点:
- RoboSpatial-Home:73.9分。 重点是理解真实家庭场景中的物体位置、遮挡和相互关系,这是机器人寻找、抓取和放置物体的前提。
- RoboRefit:89.8分。 模型需要在复杂视觉场景中定位指定目标,为后续动作提供稳定的视觉锚点。
- SimplerEnv:53.9%的成功率。 反映模型从人类视角监督迁移到下游控制任务的效果。
- RoboTwin 2.0:90.48%的成功率。 说明其在仿真或标准化任务中的动作规划已经具备较强可用性。
- 真实世界 Agibot:平均成功率0.74。 相比0.62的基线有所提升,但离通用机器人在开放环境中稳定工作仍有距离。
这些指标放在一起看,比“全球第一”的宣传语更有价值:PhysBrain 1.5的优势并非集中在某一个视觉问答项目,而是覆盖感知、空间推理、规划、定位和执行迁移的系统性表现。
从“看懂”到“做到”,关键在 Physical Loop
物理智能和普通多模态理解的分界线,可以用一个很直观的例子来解释。普通视觉模型看到桌上的杯子,可能知道它是杯子,也能回答杯子在书的右边。但机器人真正要完成“把杯子放进盒子”,还要判断:杯子的把手朝向哪里,手臂从哪个方向接近不会碰倒旁边的物体,抓取后盒子是否够高,以及动作完成后下一次观察应该关注什么。
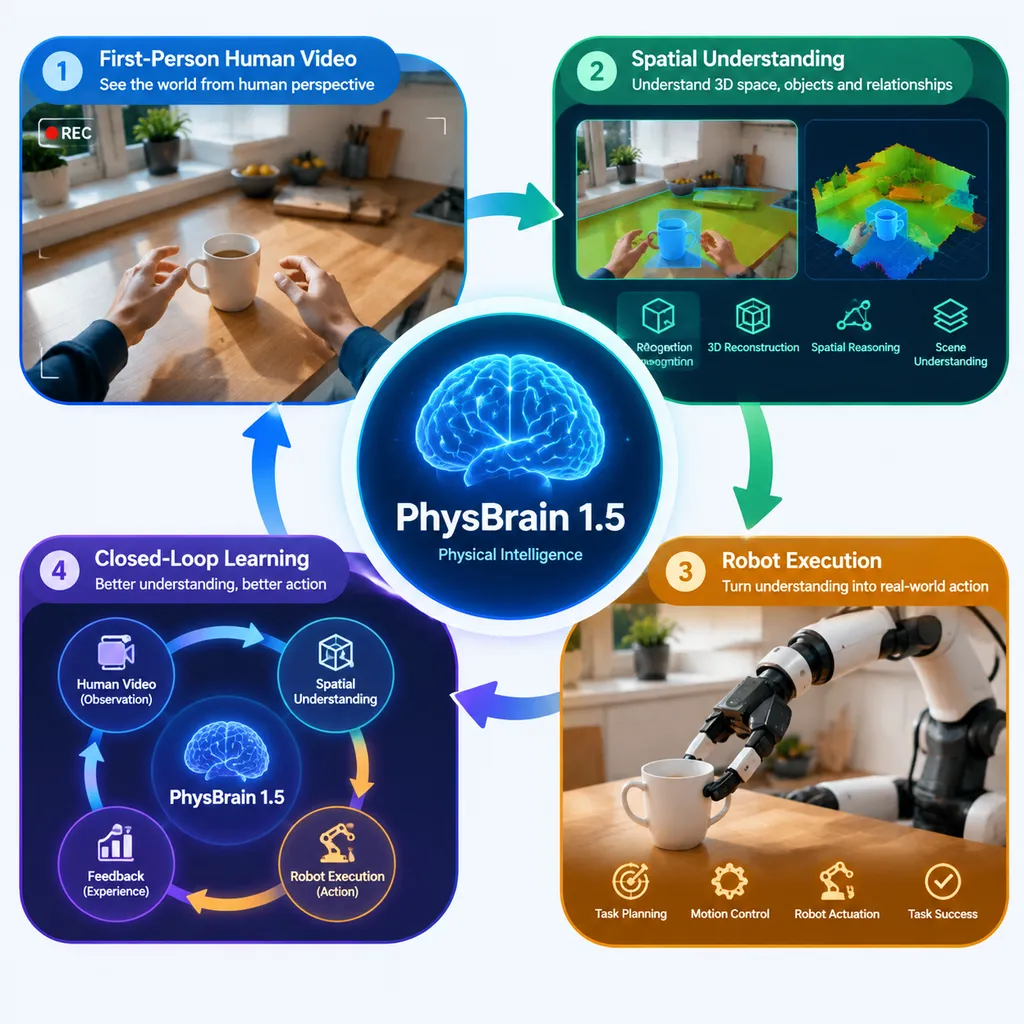
这就是深度机智所说的 Physical Loop:
- 观察环境;
- 理解空间关系和任务目标;
- 预测某个动作可能造成的状态变化;
- 执行动作;
- 根据新的视觉反馈修正计划。
行业里常见的做法,是把视觉语言模型、动作策略模型、世界模型和控制模块拼起来。模块化并没有错,事实上它更容易调试,也更适合工程落地。但问题在于,模块之间容易出现信息断裂:负责“理解”的模型不知道执行器的限制,负责“动作”的模型又未必真正理解语言任务,预测模块和控制模块还可能使用不同的空间表示。
PhysBrain 1.5的路线,是把理解、动作和预测收进同一个自回归主干。模型不只生成“下一句话”,也尝试生成与动作和未来状态有关的统一序列。理想状态下,这相当于让模型内部同时拥有一张“世界地图”和一份“操作草稿”:它知道眼前有什么,也知道动手之后场景会怎样变化。
这条路线的好处是跨任务迁移更自然。比如,模型在第一视角视频里学到“手伸向物体前要避开遮挡”,这种经验不必绑定到某一款机械臂上,而可以迁移到不同机器人或不同操作任务。难点则同样明显:统一表示要足够丰富,数据要足够连续,模型还必须学会处理真实世界中的噪声、延迟和失败。
ActionPiece:把动作和后果放在一起学
PhysBrain 1.5引入的 ActionPiece,是这套闭环里的核心机制之一。简单说,它不只训练模型回答“下一步该做什么”,还让模型学习“做完之后可能变成什么样”。
对机器人来说,动作本身不是最终目标。抓取、推、拉、旋转这些动作,价值取决于它们是否让环境更接近任务完成。只学动作,模型容易变成条件反射;同时学习状态预测,模型才有机会形成最基础的因果判断。
按照团队披露的内部实验,PhysBrain 1.5的动作预测能力从24%提升到54%。这个数字不能直接等同于真实机器人成功率,也不能证明模型已经掌握通用物理规律,但它至少指向一个正确的训练方向:让动作生成不再是孤立的策略输出,而成为“观察—预测—行动”序列的一部分。
这也解释了为什么第一人称人类视频会成为重要数据来源。机器人真机数据昂贵、稀缺,而且通常只覆盖被设计好的任务;人类视角视频则包含大量自然发生的经验:先移开挡路物体、拿取前调整手的角度、失败后换一种方式、完成任务前不断确认目标位置。
深度机智将这类数据组织成 E2E-3M 等训练资源,把第一人称视频转换为多级、schema驱动的视觉问答监督,包含规划分解、关键状态、交互约束和时间关系。相比逐帧描述,这类数据更接近“为什么现在要做这个动作,以及这个动作会带来什么后果”。
“人类学习”路线,优势与风险都很明显
深度机智从2025年起持续强调“人类学习”路线:以人类第一视角经验为数据起点,以动作作为建模中心,再通过机器人本体验证模型能力。PhysBrain 1.0在今年3月发布,1.5在半年后跟进,迭代节奏本身说明团队并非只押注一个概念,而是在持续打通数据、模型和本体之间的反馈链路。
这套方法的最大优势,是降低对海量机器人数据的依赖。机器人数据每小时都带着硬件成本,换一个机械臂、换一个摄像头、换一个控制频率,很多数据就不能直接复用。人类视频虽然缺少机器人关节信息,却拥有更丰富的任务语境和物理常识,适合作为通用预训练的基础。
但它也有不能回避的短板。人类手臂和机器人机械臂的形态不同,人类的触觉、柔顺性和双手协调能力也不是普通摄像头能完整记录的。模型从“人怎么做”迁移到“机器人怎么做”,中间仍需要动作映射、仿真训练和真实世界纠错。
所以,PhysBrain 1.5的价值不在于宣称“人类视频已经解决机器人学习”,而在于证明这条数据路线可以持续转化为可测量的空间推理和控制能力。它把一个长期被讨论的假设,推进到了更具体的工程验证阶段。
2B版本的意义,可能比榜首更大
8B版本负责冲击性能上限,2B版本则更贴近部署现实。PhysBrain 1.5-2B在同一套28项测试中拿到66.6分,官方将其作为参考版本,不纳入开源排名;但若只比较综合分,它已经超过Hy-Embodied-VLM-1.0的66.0、Embodied-R1.5的64.9和RynnBrain 1.1的63.1。
这对机器人开发者很关键。物理智能最终不能只运行在数据中心,还要进入边缘设备、机器人控制器和本地工作站。模型越小,延迟、显存和部署成本越容易控制,开发者也越有机会把它放进真实闭环,而不是停留在离线演示。
不过,“2B跑得动”不等于“2B能直接控制机器人”。真实部署还要考虑视觉输入频率、动作输出格式、控制安全边界、异常恢复和长时任务稳定性。尤其在涉及人和贵重设备的场景中,模型必须具备可中止、可回退和权限隔离机制,不能因为榜单分数高就跳过系统工程。
开源之后,开发者最该看什么
PhysBrain 1.5的开源价值,首先在于它把物理智能的研究门槛往下拉了一截。高校实验室、小型机器人团队和个人开发者可以围绕模型做三类工作:
- 评测复现: 在相同基准上验证不同数据配方、量化方式和推理框架的影响;
- 场景微调: 针对仓储分拣、桌面操作、家庭整理等窄场景补充第一视角数据;
- 模型—本体适配: 将统一动作空间映射到不同机械臂、灵巧手或移动底盘。
如果模型权重、训练代码和数据规范能够持续开放,其社区价值会远高于一次榜单登顶。真正值得观察的是后续是否出现独立复现、不同本体上的迁移结果,以及模型在长时任务和失败恢复上的公开数据。
从部署角度看,8B和2B两档规模也给出了比较清晰的选择:8B适合云端推理、离线评测和复杂规划,2B更适合边缘侧实验和低延迟场景。开发者不应只盯着综合分,还要关注许可证、权重格式、推理吞吐、显存占用,以及模型能否输出稳定、可执行的动作表示。
这不是终局,而是竞争方式变了
Google DeepMind的 Gemini Robotics、Physical Intelligence 的 π 系列、Figure 等公司,分别从具身推理、机器人数据、少样本适应和整机系统切入;NVIDIA Cosmos 3等方案则继续强化世界模型和仿真基础设施。全球竞争已经不是“谁先做出一个会说话的机器人”,而是谁能把数据、模型、仿真、硬件和真实反馈组织成更短的闭环。
在这个背景下,PhysBrain 1.5登顶开源榜的意义有两层。第一层是产品层:开发者终于多了一个在空间智能和具身推理上具备较高起点的开源基座。第二层是路线层:它证明了8B级模型结合人类第一视角数据、统一动作建模和本体验证,能够在公开评测中逼近顶尖闭源系统。
但榜单第一离通用物理智能仍然很远。机器人面对真实世界时,要处理光照变化、软体物体、摩擦差异、遮挡、传感器噪声和任务目标变化,还要在连续数分钟甚至数小时内保持稳定。公开基准更像是体检报告中的专项指标,不是完整的“上岗证明”。
我的判断是:PhysBrain 1.5值得关注,但不必神化。它最有价值的不是“8B击败所有大模型”这样的标题,而是把物理AI从单点识别和动作模仿,推向了统一空间表征、动作预测与反馈修正。接下来,开源社区能否在真实本体上复现这些结果,才是决定它影响力的关键。
对于想快速试用不同模型的开发者,OpenAI Hub 这类兼容 OpenAI 格式的聚合平台更适合做文本和多模态模型的横向测试;但 PhysBrain 1.5属于开源物理AI模型,真正的价值仍在本地权重、机器人数据和控制系统的协同,而不是简单接一个 API 就能完成部署。
参考来源
- 知乎专栏:缩小物理智能鸿沟:深度机智 PhysBrain 1.5 登顶开源:介绍模型架构、评测成绩与“人类学习”路线。
- CSDN:京东 JoyAI 物理基座模型 PhysBrain 1.5 发布拆解:整理模型参数规模、数据构建、仿真与真实世界测试信息。
注:文中分数和能力描述依据公开资料整理。不同基准的评测协议、模型版本和推理设置可能存在差异,相关结果应以项目方后续发布的权重、代码和独立复现为准。