iPhone成Mac的第二块GPU
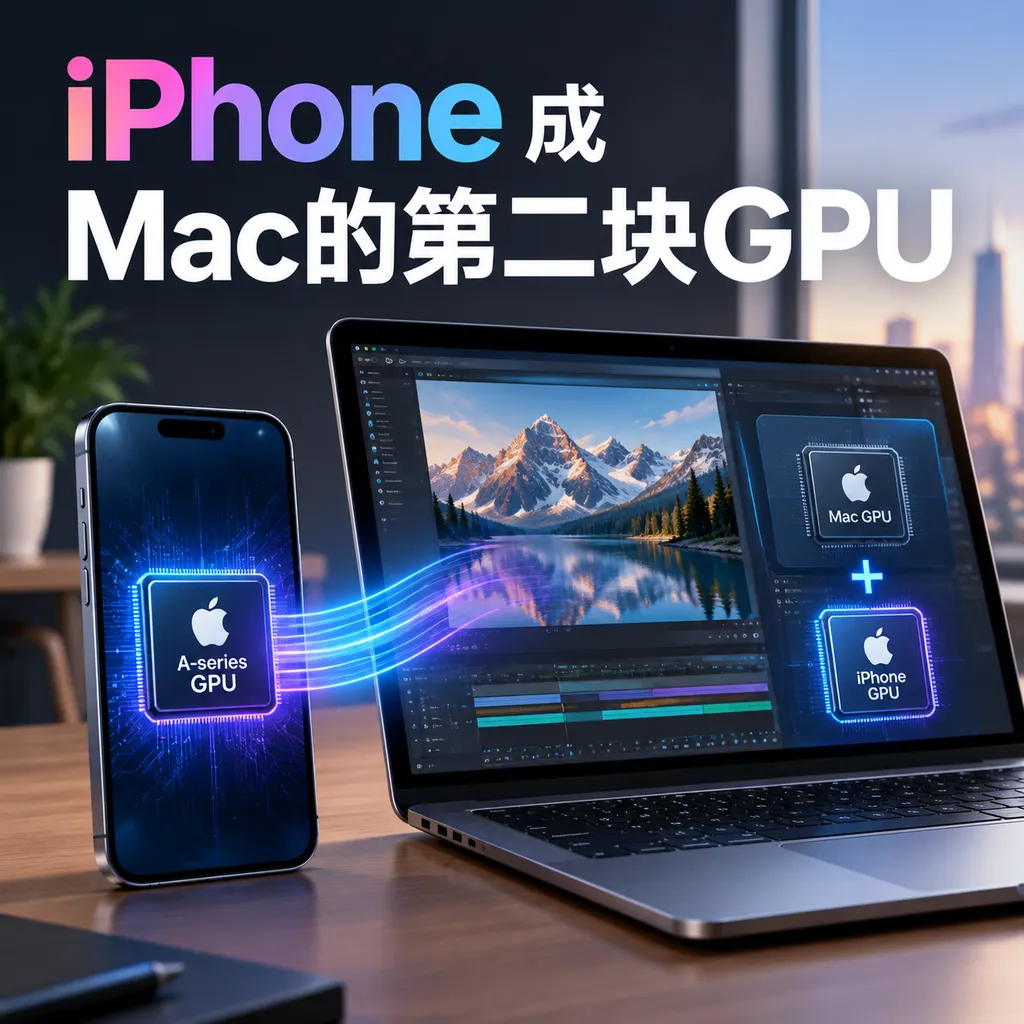
一名开发者通过USB-C将iPhone 17 Pro Max接入M4 Pro MacBook Pro,协同运行Qwen3.8-27B。在16K上下文预填充任务中,速度从109 token/s提升至157 token/s,最高增幅44%。
一根线,让iPhone给MacBook Pro分担大模型计算
苹果设备之间的性能边界,正在变得比产品规格表更模糊。
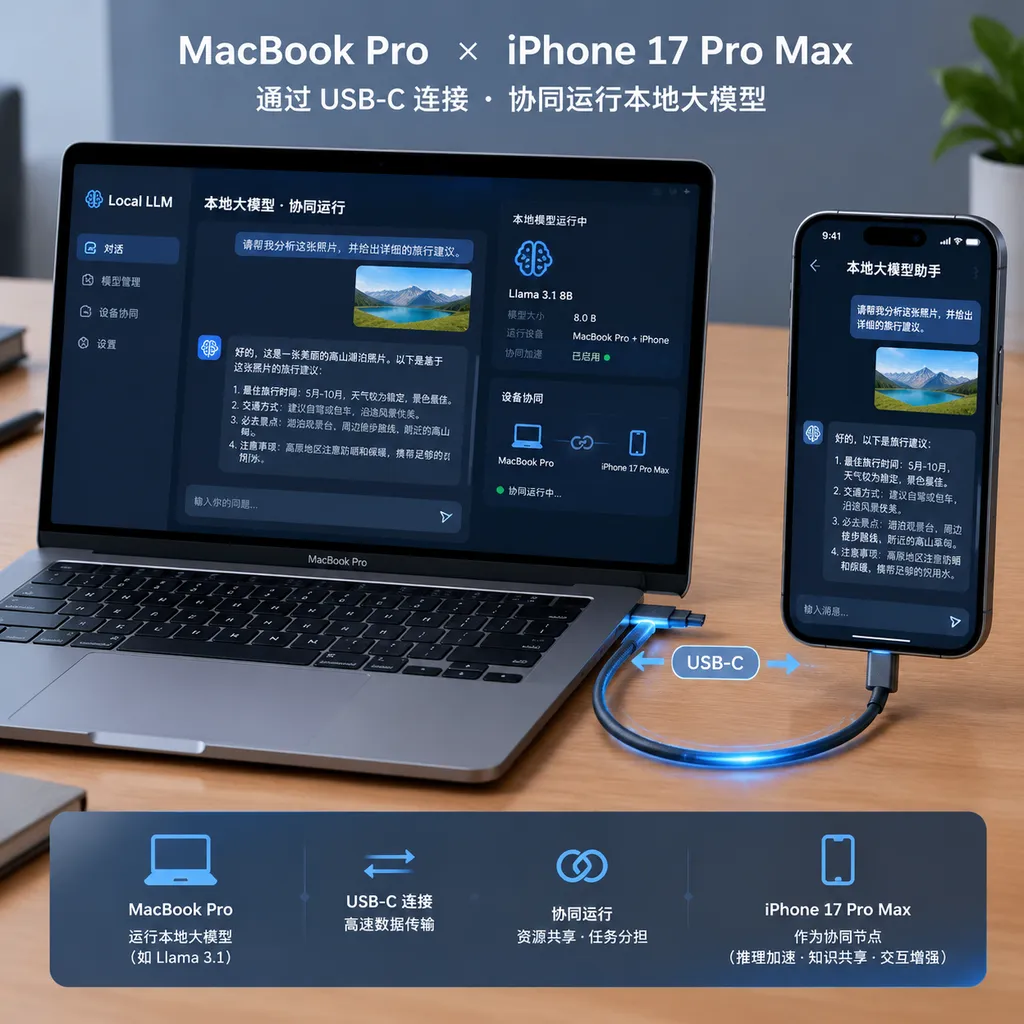
10月4日消息,一名开发者通过USB-C将iPhone 17 Pro Max接入搭载M4 Pro芯片的MacBook Pro,并借助自制软件让两台设备协同运行Qwen3.8-27B。在一组本地推理测试中,外接iPhone后,模型的上下文预填充性能最高提升44%。
这不是把iPhone简单当成外接显卡,也不是macOS原生支持的新功能。开发者真正做的是把模型不同层的计算任务拆开,再通过USB-C传输中间激活值,让Mac和iPhone组成一条流水线。
结果很有意思:一台只有24GB统一内存的MacBook Pro,在运行27B级别模型时,借助一部手机获得了接近额外加速器的效果。
关键不在算力,而在内存和任务拆分
运行大语言模型时,开发者通常会先关注芯片的GPU核心数量和内存带宽。但对于Qwen3.8-27B这类模型,真正容易先撞上的瓶颈往往是显存或统一内存容量。
M4 Pro版MacBook Pro拥有24GB统一内存。统一内存的好处是CPU和GPU可以共享同一块内存,不需要像传统PC那样在系统内存与显存之间反复搬运数据;但它的限制也很直接:总容量就是24GB,系统、模型权重、KV Cache和推理过程中的临时数据都要在这里分配。
27B参数级别模型即使经过量化,也会对内存空间提出不低要求。上下文越长,KV Cache占用越大;输入文档越长,预填充阶段需要处理的token越多。设备不一定完全跑不动,但速度会受到内存容量、带宽和缓存命中率的共同影响。
这次实验采用的是分层推理。根据开发者公布的方案,在每批256个token的计算中:
- MacBook Pro负责模型第1层到第40层的计算;
- Mac将中间激活值通过USB-C传给iPhone 17 Pro Max;
- iPhone利用A19 Pro的GPU继续处理第41层到第64层;
- 在iPhone处理当前批次的同时,Mac开始准备下一批数据。
这相当于把模型推理变成了两段流水线。Mac不需要等iPhone完整处理完一批数据后才开始下一步,而是继续向前推进;iPhone也不是被动接收完整模型,而只负责其中一部分层。
可以用下面这个简化流程理解这套方案:
第N批 token:
Mac 处理第1-40层  -> USB-C传输激活值 -> iPhone处理第41-64层

第N+1批 token:
Mac 处理第1-40层  --------------------> 等待下一次传输
真正决定效果的,不只是A19 Pro的GPU有多快,还包括数据传输是否足够稳定、两边的计算能否重叠,以及拆分位置是否合理。如果Mac算完一批数据后必须长时间等待手机,或者USB-C传输成为新的瓶颈,外接设备反而可能拖慢整体速度。
16K上下文下,性能提升最明显
测试结果显示,外接iPhone带来的收益主要集中在预填充阶段,也就是模型读取输入内容、建立上下文状态的过程。这个阶段对并行计算更加敏感,适合把大量token分批送入模型处理。
在一项处理并保存2000 token文件的测试中,结果如下:
| 上下文窗口 | 仅使用MacBook Pro | 外接iPhone 17 Pro Max | 性能提升 | |---|---:|---:|---:| | 8K | 132 token/s | 177 token/s | 35% | | 16K | 109 token/s | 157 token/s | 44% | | 32K | 101 token/s | 130 token/s | 29% |
16K上下文是这套协同方案表现最好的区间。速度从每秒109个token提升到157个token,绝对增幅为48 token/s,比例达到44%。8K上下文下,速度提升35%;上下文扩大到32K后,提升幅度回落至29%。
这组数据说明,外接iPhone并不是上下文越长、收益越大。系统存在一个由计算、内存和传输共同决定的平衡点。上下文较短时,Mac本身可能还没有完全暴露出瓶颈,外接设备的收益有限;上下文继续增大后,KV Cache和中间数据的压力上升,USB-C传输、同步等待以及内存管理的成本也会变得明显。
因此,44%更适合被理解为特定工作负载下的峰值,而不是一个可以套用到所有本地推理任务上的固定倍率。
A19 Pro的GPU和神经网络引擎都被用上了
这次实验的另一个看点,是开发者没有只调用iPhone的GPU。
在相关测试中,iPhone端使用A19 Pro GPU运行模型后半段,相比不使用GPU的方式,运行速度提升约2.4倍。对于本地大模型而言,GPU的价值在于同时处理大量矩阵运算。Transformer模型中的线性层、注意力计算和多层感知机,都适合交给GPU执行。
不过,在超长上下文场景中,GPU并不是唯一的优化方向。开发者还让A19 Pro的神经网络引擎参与计算:每16K长度的历史上下文会被编译成一套专用的神经网络模型,用于处理后续的上下文写入。
在140K上下文长度下,仅使用A19 Pro GPU时,单个token写入耗时为279毫秒;加入神经网络引擎后,耗时降低到176毫秒。这个结果意味着,神经网络引擎在重复性较高、结构相对固定的长上下文处理任务中,可能比单纯增加GPU计算更有效。
这也反映出苹果芯片在本地AI上的一个特点:CPU、GPU和神经网络引擎并不是互相替代的三套硬件,而是分别适合不同类型的任务。GPU更适合大规模并行张量计算,神经网络引擎则适合经过编译和固定化的算子路径,CPU负责调度、控制和一部分不适合加速器处理的工作。
如果软件栈能够把任务拆得足够细,消费级设备上的多个计算单元确实可以被同时调动起来。问题在于,这种效率需要专门的推理引擎、算子适配和内存管理支持,不能指望把一根USB-C线插上去就自动发生。
它加速的是读入,不是完整对话体验
这套方案最大的限制也很明确:iPhone主要提升预填充性能,并不能等比例提升所有生成任务。
在64K以内的场景中,文本生成阶段的大部分实际推理仍然主要由MacBook Pro完成。换句话说,用户把一份长文档交给模型时,iPhone可以帮助模型更快地读完这份文档;但模型开始逐字生成答案后,手机并不会继续以同样的幅度参与每一步解码。
这两类阶段的计算特征不同:
- 预填充阶段:一次性处理大量输入token,适合批量并行,GPU和多设备流水线更容易发挥作用;
- 解码阶段:模型每次生成一个或少量token,上一轮输出会影响下一轮,计算更偏串行,设备间通信延迟会变得更加重要。
因此,外接iPhone对以下工作更有价值:长文档总结、代码仓库分析、批量文件预处理、长上下文检索增强,以及需要一次性读入大量内容的开发工具。
如果任务只是普通聊天、短文本改写或几百token的代码补全,预填充本来就不是主要耗时,外接iPhone很可能带来不了明显体感提升。对于追求持续生成速度的本地聊天用户,这套方案也没有数据证明能够显著提高最终token输出速度。
还有一个现实问题:目前这不是普通用户可以直接部署的方案。它依赖开发者自制的软件,需要处理模型分层、激活值传输、设备同步、算子兼容和内存调度等问题。即使硬件配置相同,不同的模型量化格式、上下文长度和推理引擎,也可能得到完全不同的结果。
这更像一个软件工程问题,而不是硬件外挂
从工程角度看,这次实验的价值不在于证明iPhone可以替代显卡,而在于展示了一种本地推理的拆分思路:模型不必完整驻留在一台机器上,推理过程也不一定要由同一种处理器独占完成。
过去,个人设备运行大模型时,通常只能在几个选项之间做选择:换更大内存的电脑、降低量化精度、缩短上下文,或者接受更慢的速度。这次实验提供了第五种思路,即把不同设备的计算资源拼接起来。
但设备拼接并不免费。它会引入三类成本:
- 通信成本:模型层之间传输的是激活值,不是几个简单的控制信号。激活值规模、传输频率和USB-C链路效率都会影响结果。
- 调度成本:两台设备需要在正确的时间处理正确的批次。流水线一旦失衡,快的一方就会等待慢的一方。
- 软件维护成本:模型结构、量化格式和芯片后端不断变化,分层方案需要针对具体模型和硬件重新调试。
所以,这不是把手机变成MacBook Pro的永久“第二块GPU”,而是一次针对特定模型、特定芯片和特定上下文任务的定制优化。它的上限很高,但通用性还远未达到产品化水平。
对本地AI开发者意味着什么
这次实验给本地AI开发者的启发,主要有三点。
第一,评估端侧模型时,不能只看模型能不能启动。启动成功、首token延迟、预填充速度、解码速度和长上下文吞吐量,是几种不同的指标。一个模型可以成功加载,但在处理长代码库时依然慢到无法使用;也可以在预填充阶段很快,却在逐token生成阶段表现一般。
第二,统一内存并不等于无限内存。苹果芯片的统一内存减少了CPU与GPU之间的数据复制,但模型权重、KV Cache和系统进程仍然会争抢同一块物理内存。遇到27B级别模型时,如何分配内存、如何复用缓存,往往比理论峰值算力更重要。
第三,未来的端侧推理优化可能越来越依赖异构协同。手机、平板、笔记本和桌面设备之间,只要能通过低延迟接口共享中间结果,就有机会形成一套临时计算集群。这个方向未必会取代高端GPU,但对于开发者工作站、移动办公和隐私敏感的本地AI场景,确实值得继续探索。
目前,OpenAI Hub这类兼容OpenAI格式的聚合平台更适合需要稳定调用云端模型的生产环境;而这次实验代表的是另一条路线:把模型尽量留在本地,通过设备协同换取更好的隐私和离线能力。两者解决的问题不同,不能简单用单次token速度直接比较。
总的来说,iPhone 17 Pro Max给M4 Pro MacBook Pro带来的不是一场硬件规格上的逆袭,而是一次很典型的开发者式优化:在内存有限、设备现成、软件可控的条件下,把原本闲置的计算资源组织起来。44%的预填充提升足够亮眼,但真正值得关注的是,端侧大模型的性能竞争正在从单芯片跑分,转向模型切分、流水线调度和异构计算的综合能力。
参考来源
- IT之家:苹果 MacBook Pro 外接 iPhone 17 Pro Max 运行 AI 模型,预填充性能最高提升 44% —— 提供本次实验的硬件组合、模型分层方式、测试数据及主要限制。
- 知乎:Qwen3.8-27B 在 Apple Silicon 上的本地运行讨论 —— 补充苹果芯片本地运行Qwen系列模型和推理引擎优化的背景信息。